Preview-версия будет доступна с Visiology 3.21
Cortex Дата-агент
Когда ответа нет в готовых дашбордах и данные надо исследовать
Почему расходятся цифры в отчётах? Сколько новых денег принесла акция? Агент берёт данные как есть, проверяет их, считает, уточняет правила и готовит отчёт с выводами. BI-команде он экономит часы на разовых исследованиях, бизнес-пользователю даёт ответ без SQL и очереди к аналитику.
Работает с данными Visiology и подключёнными источниками: хранилище, базы, выгрузки Excel и CSV.
Задачи BI-команды
Когда готового отчёта недостаточно
Новый вопрос бизнеса часто требует отдельного исследования: собрать данные из нескольких источников, уточнить правила расчёта и проверить результат.
Цифры не сходятся
Финансы и продажи называют разные значения одного показателя. Нужно найти причину: разные периоды, состав данных или правила расчёта.
Эффект акции неясен
Продажи выросли, но сколько из них принесла акция? Нужно проверить, с чем сравнивают результат и что ещё могло на него повлиять.
Источник ещё не описан
Вопрос уже поступил, а данные лежат в новой выгрузке. Нужно разобраться в таблицах, проверить пропуски и дубли, уточнить смысл полей.
Cortex Дата-агент помогает провести такое исследование: проверяет данные, задаёт уточняющие вопросы и сохраняет расчёты для проверки аналитиком.
Как работает · пример с банковскими вкладами
От вопроса бизнеса до отчёта с расчётами
Показываем работу агента на демонстрационном наборе.
«В июне мы запускали вклад под повышенную ставку. Сколько он принёс новых денег?»
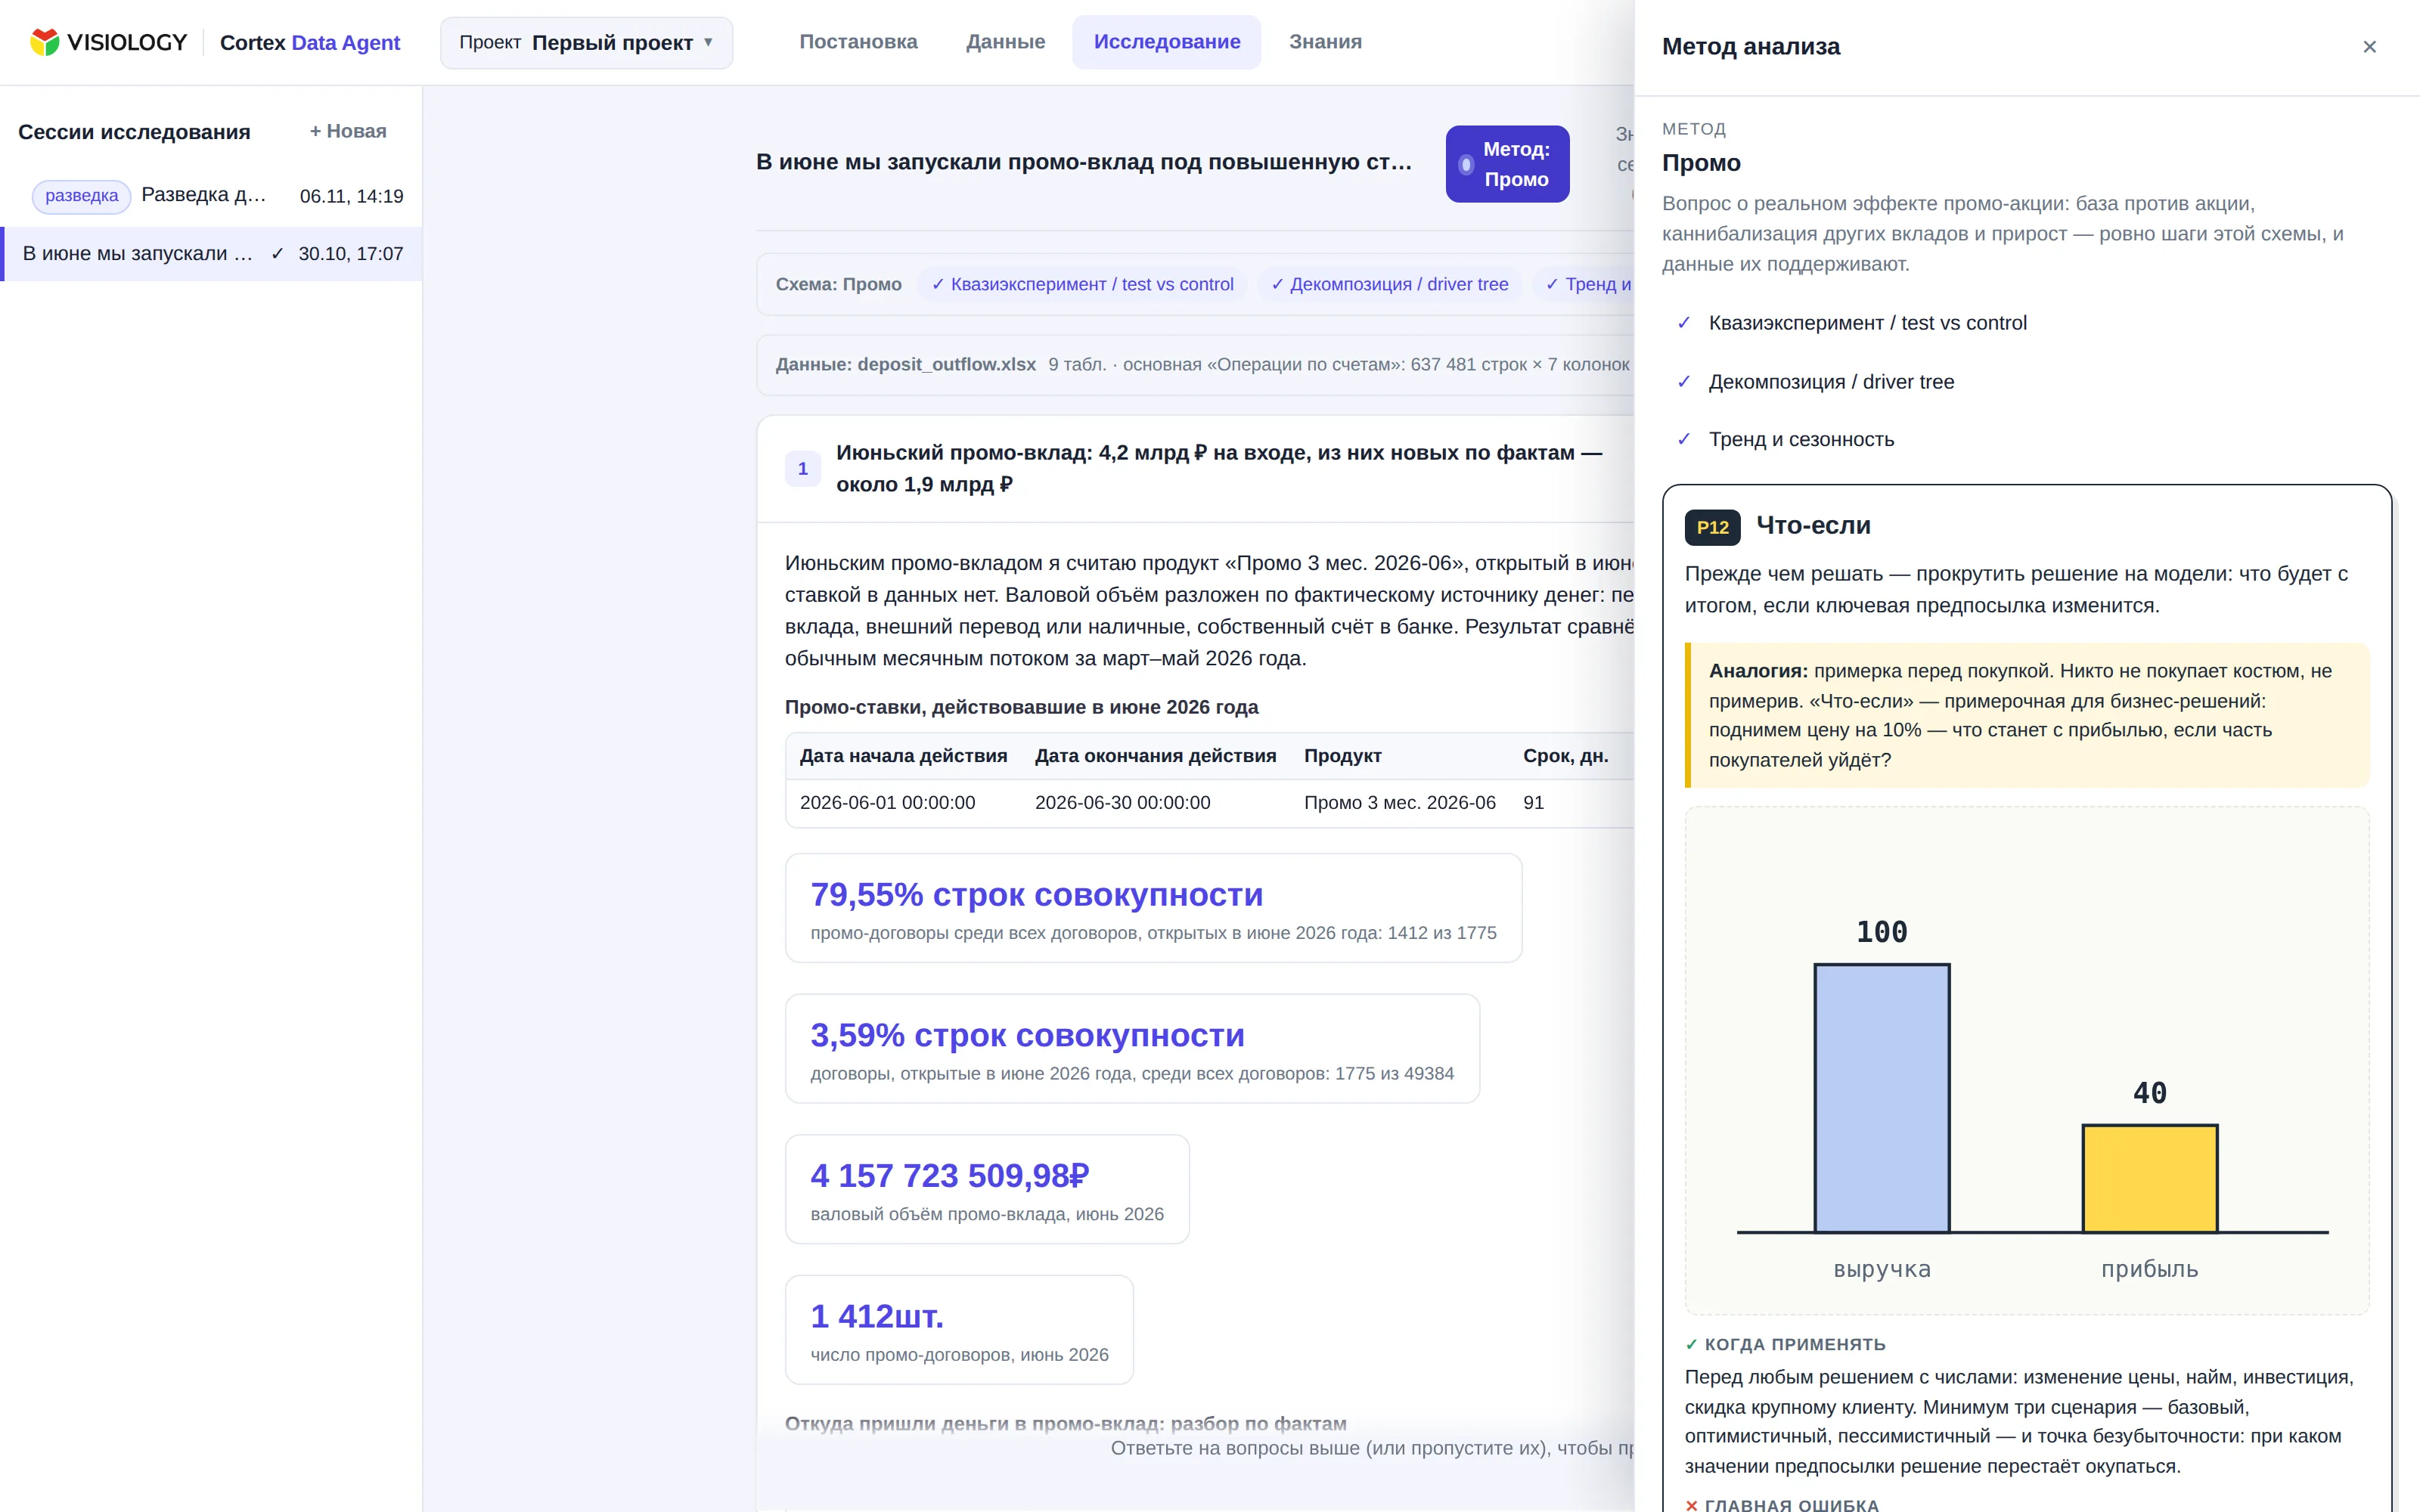
Изучает данные и показывает, что делает
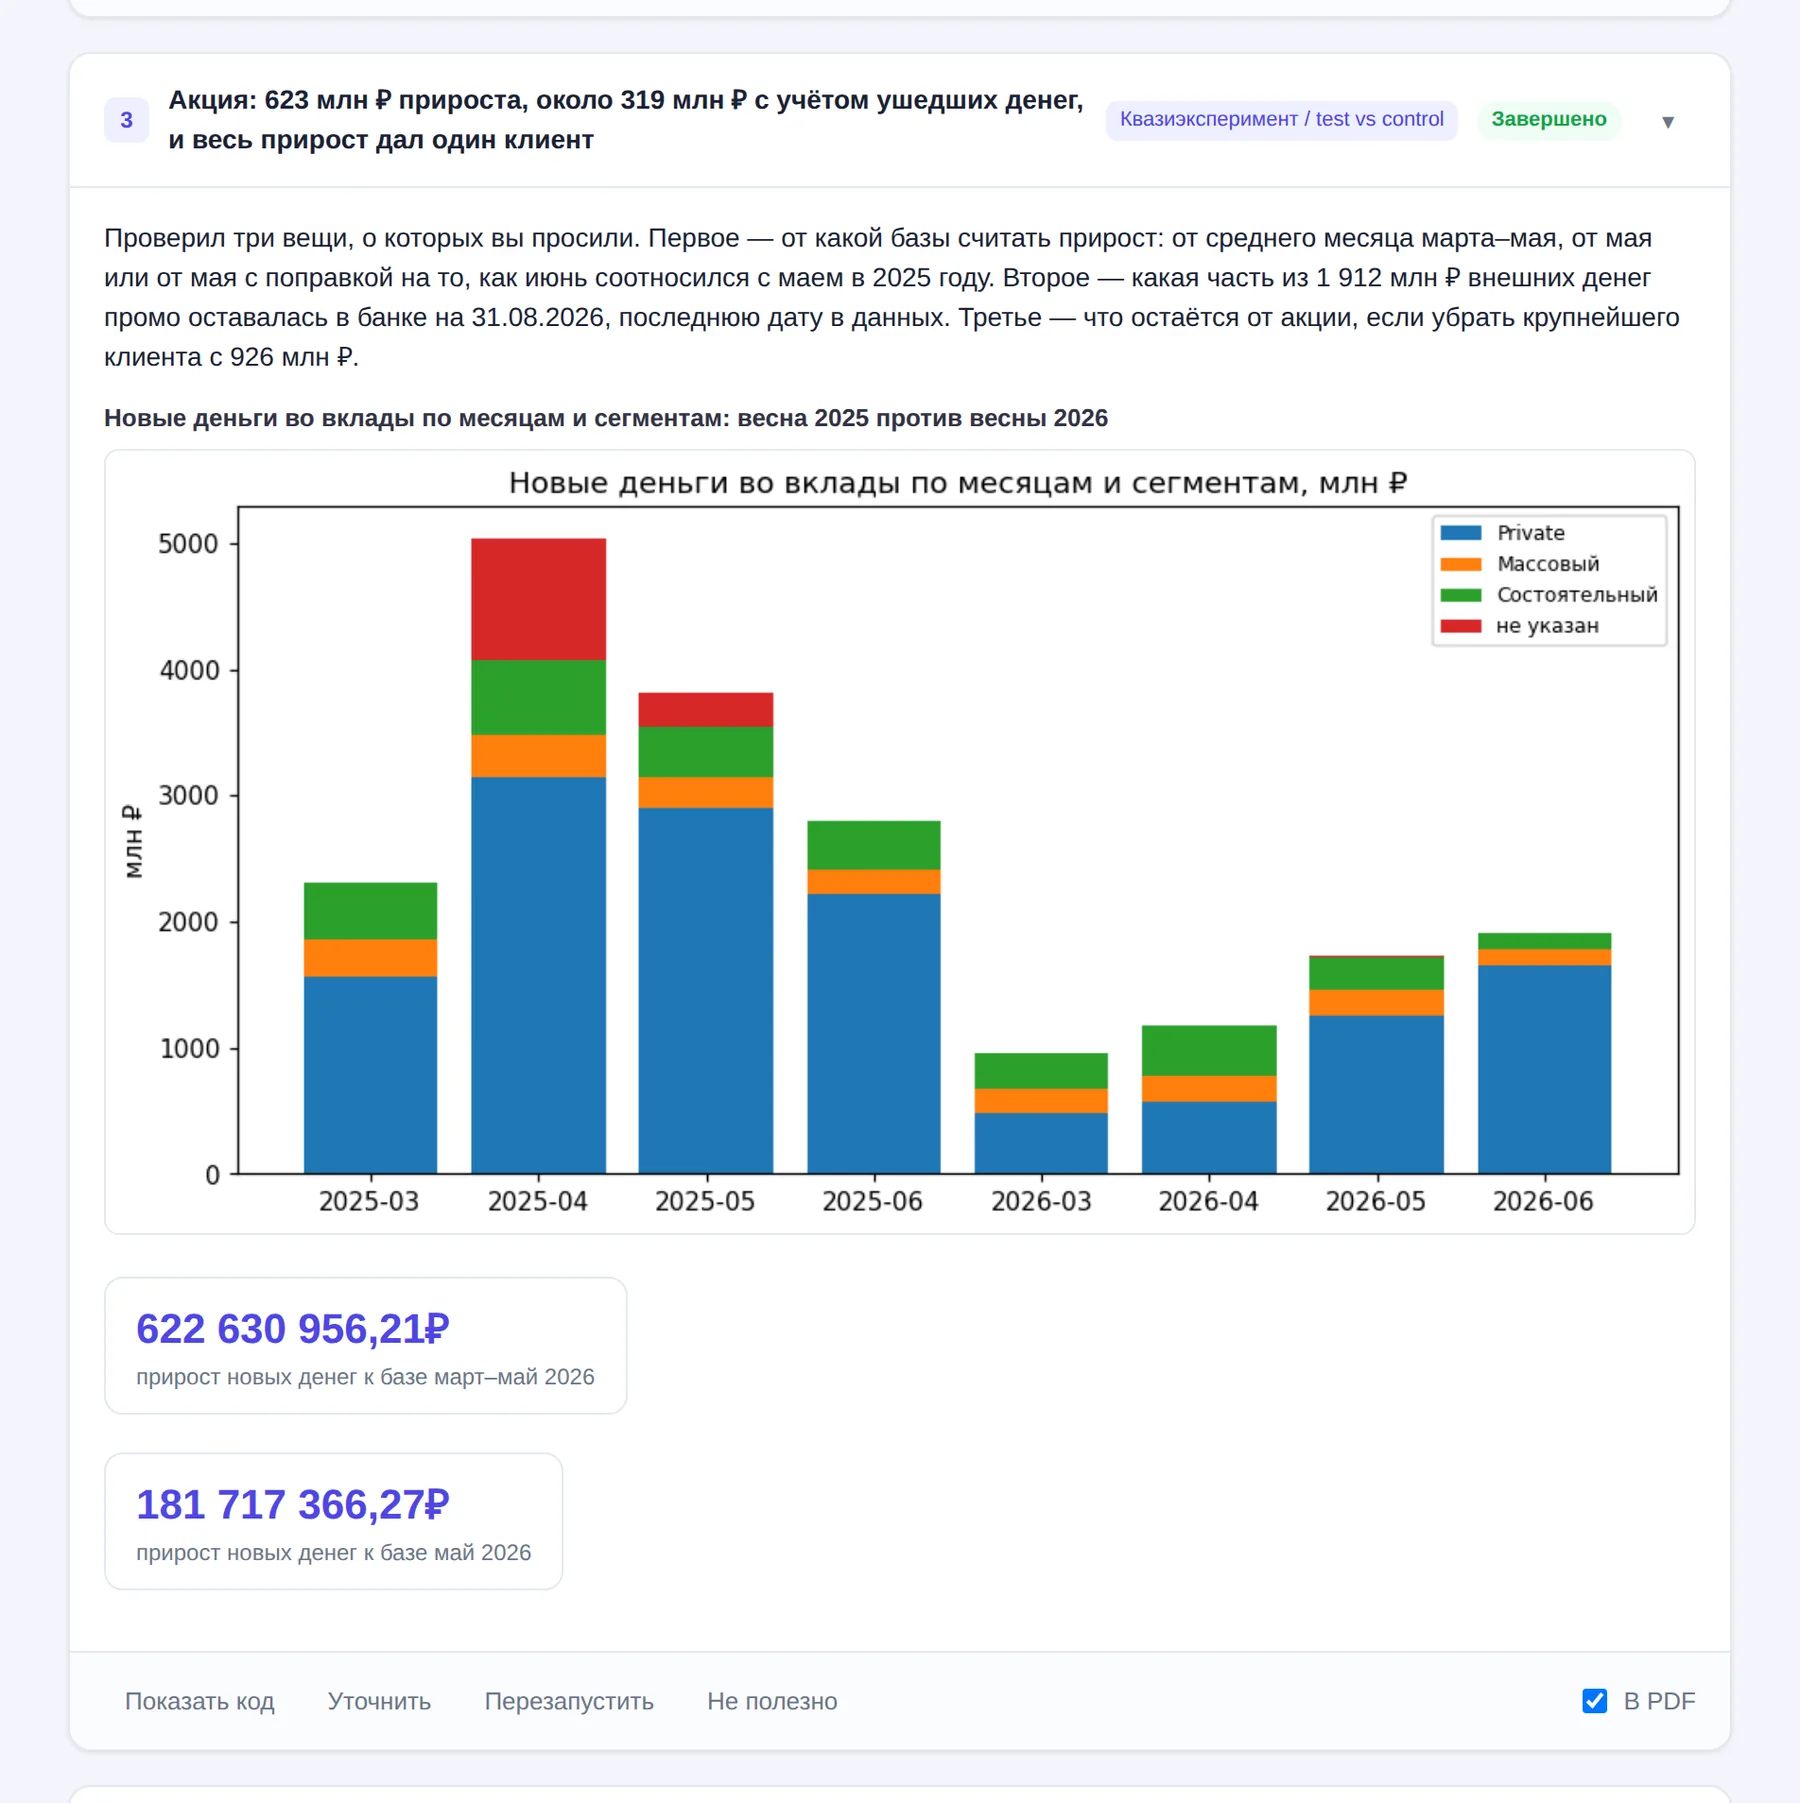
Каждый шаг виден: какие таблицы взял, что посчитал, что получилось. Промежуточные результаты выводятся таблицами, графиками и показателями, а не пересказом.
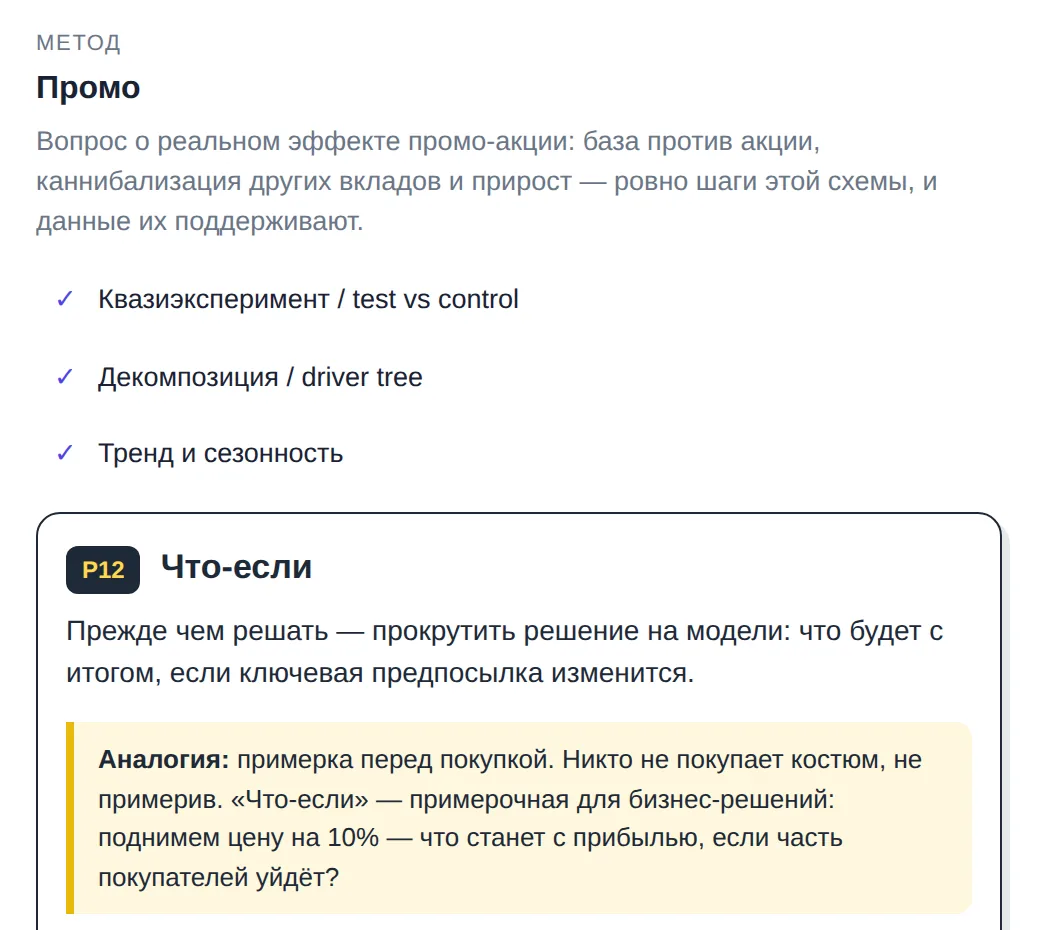
Дисциплинированно применяет аналитические практики
Под вопрос подбирается схема анализа из библиотеки проверенных практик: для эффекта акции это квазиэксперимент с контрольной группой, декомпозиция притока и поправка на сезонность. У каждой практики есть условия применения и типовые ошибки, которых агент избегает.
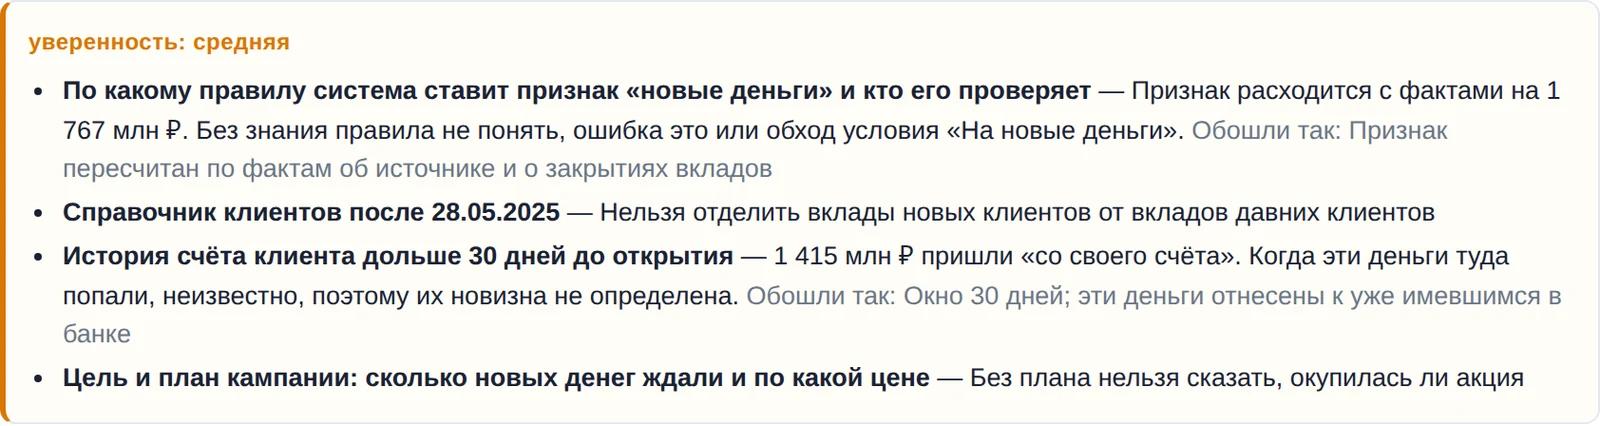
Показывает, что ещё нужно уточнить
Агент сопоставляет расчёты с результатами проверки данных и пояснениями заказчика. В ответе указывает допущения, недостающие сведения и ограничения вывода.
Спрашивает о правилах, которых нет в данных
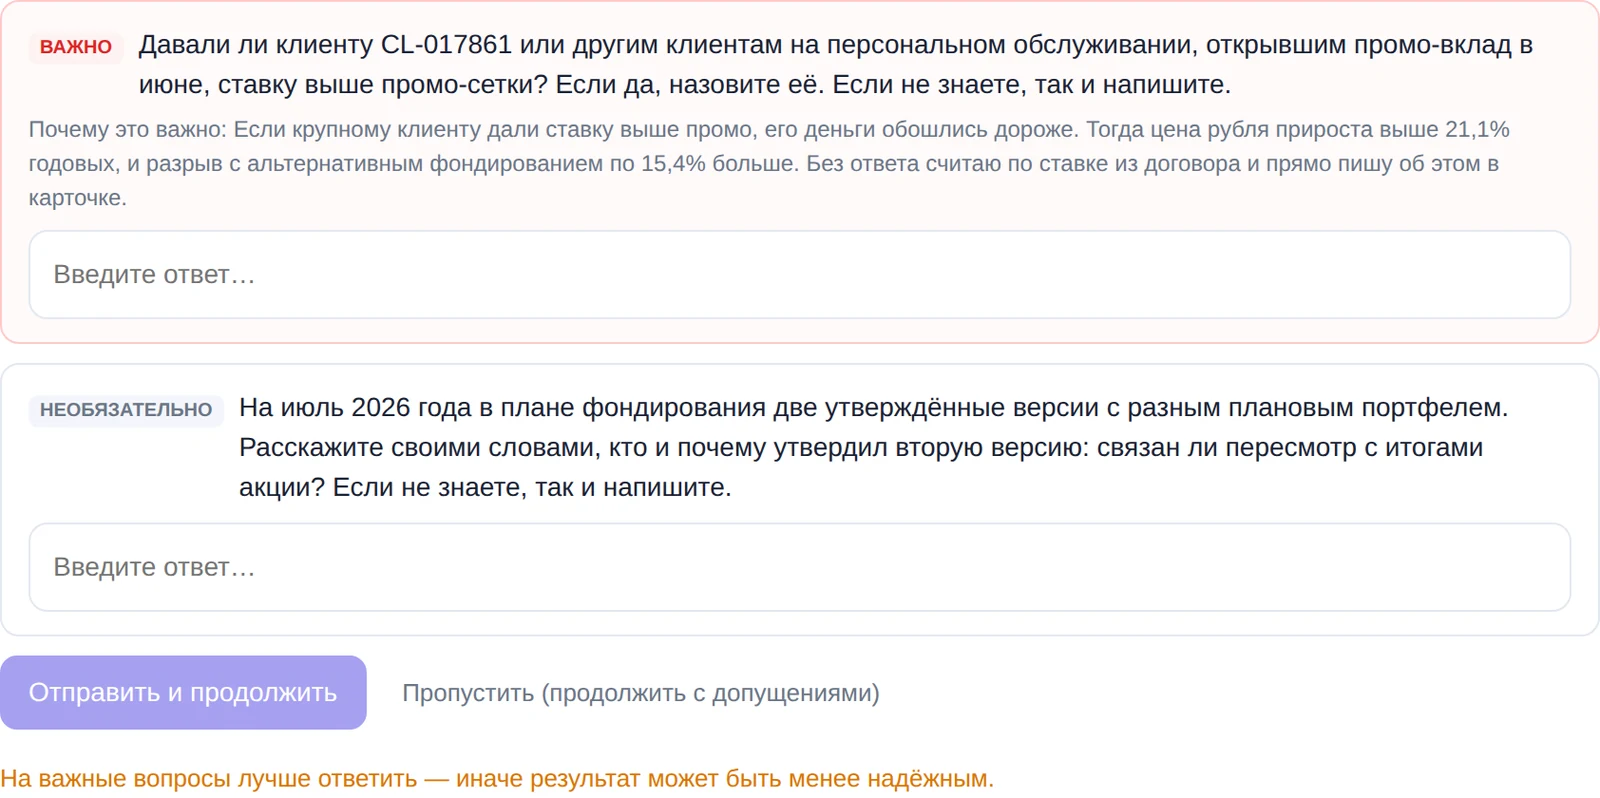
Например, что в банке считают новыми деньгами и зачем запускали акцию. Агент объясняет, для чего нужен ответ. Если вопрос пропущен, продолжает работу с явно указанным допущением.
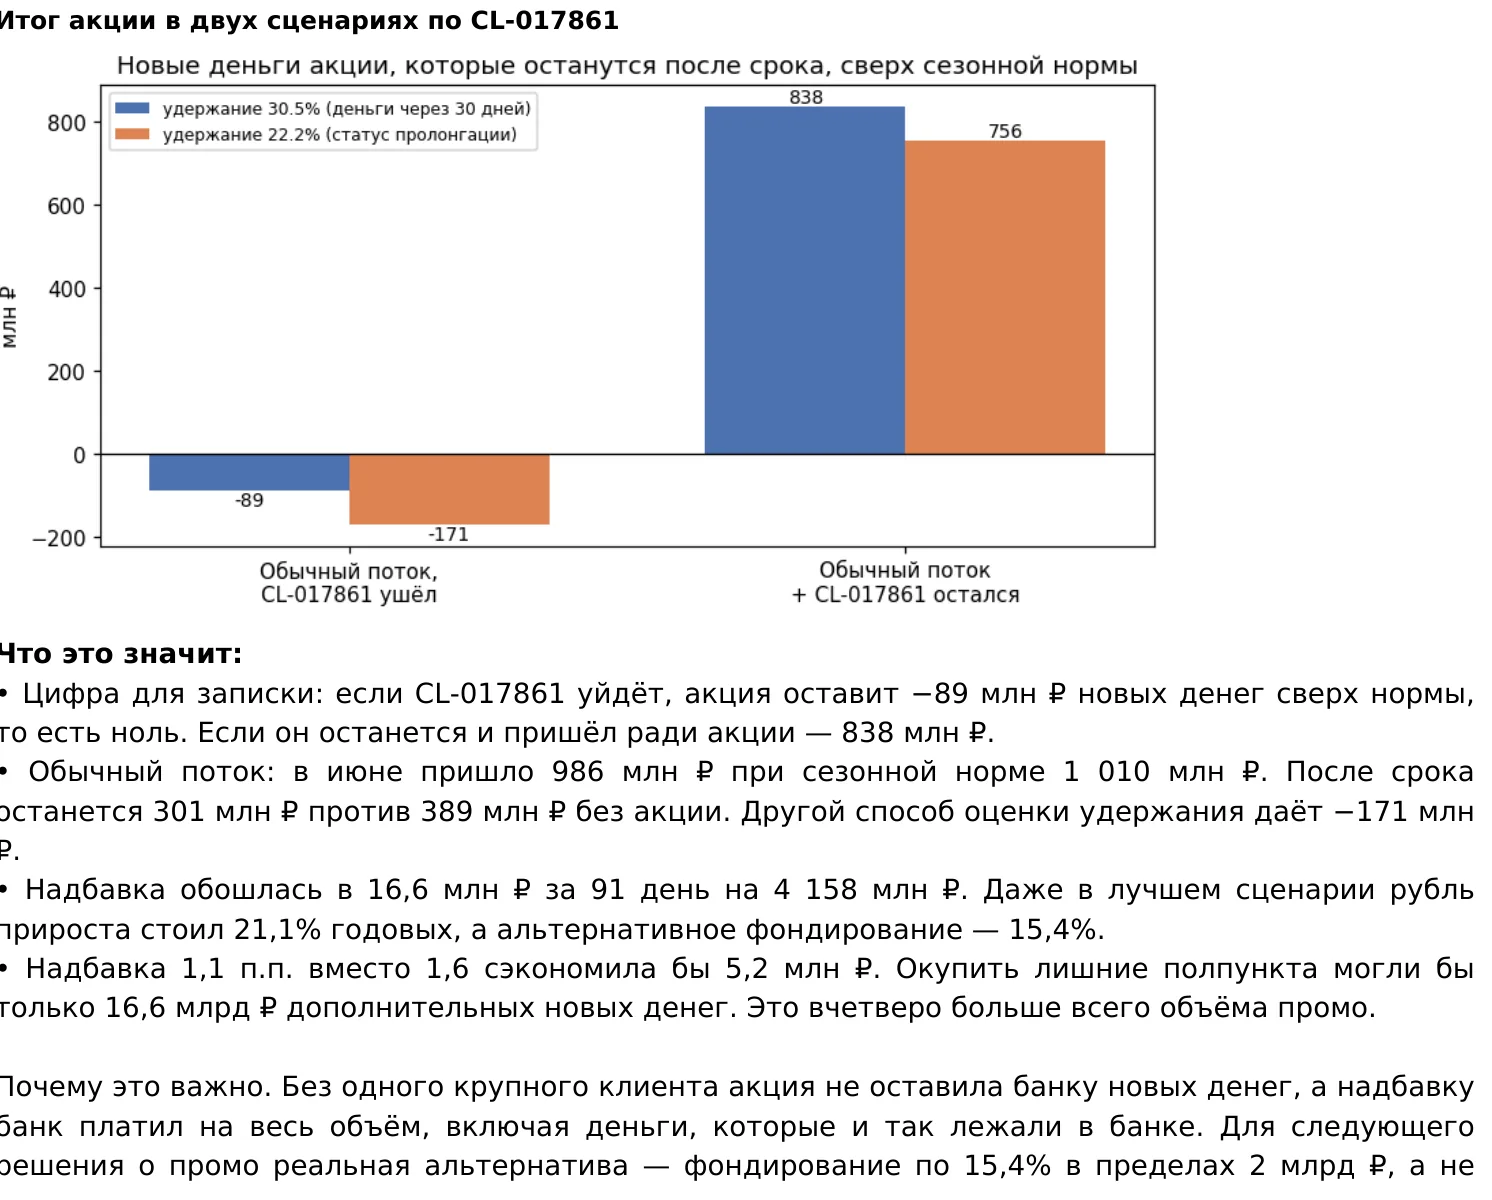
Готовит отчёт с выводами и ограничениями
Собирает результаты в один документ: какие данные использованы, как получены цифры и что требует дополнительной проверки. Отчёт можно выгрузить в PDF и обсудить с заказчиком.
Данные и правила расчёта
Можно начать с неполного описания данных
Готовые метрики, витрины и методики помогают агенту в работе. Если новый источник ещё не описан, агент проверит его структуру и задаст вопросы о значении полей и правилах расчёта.
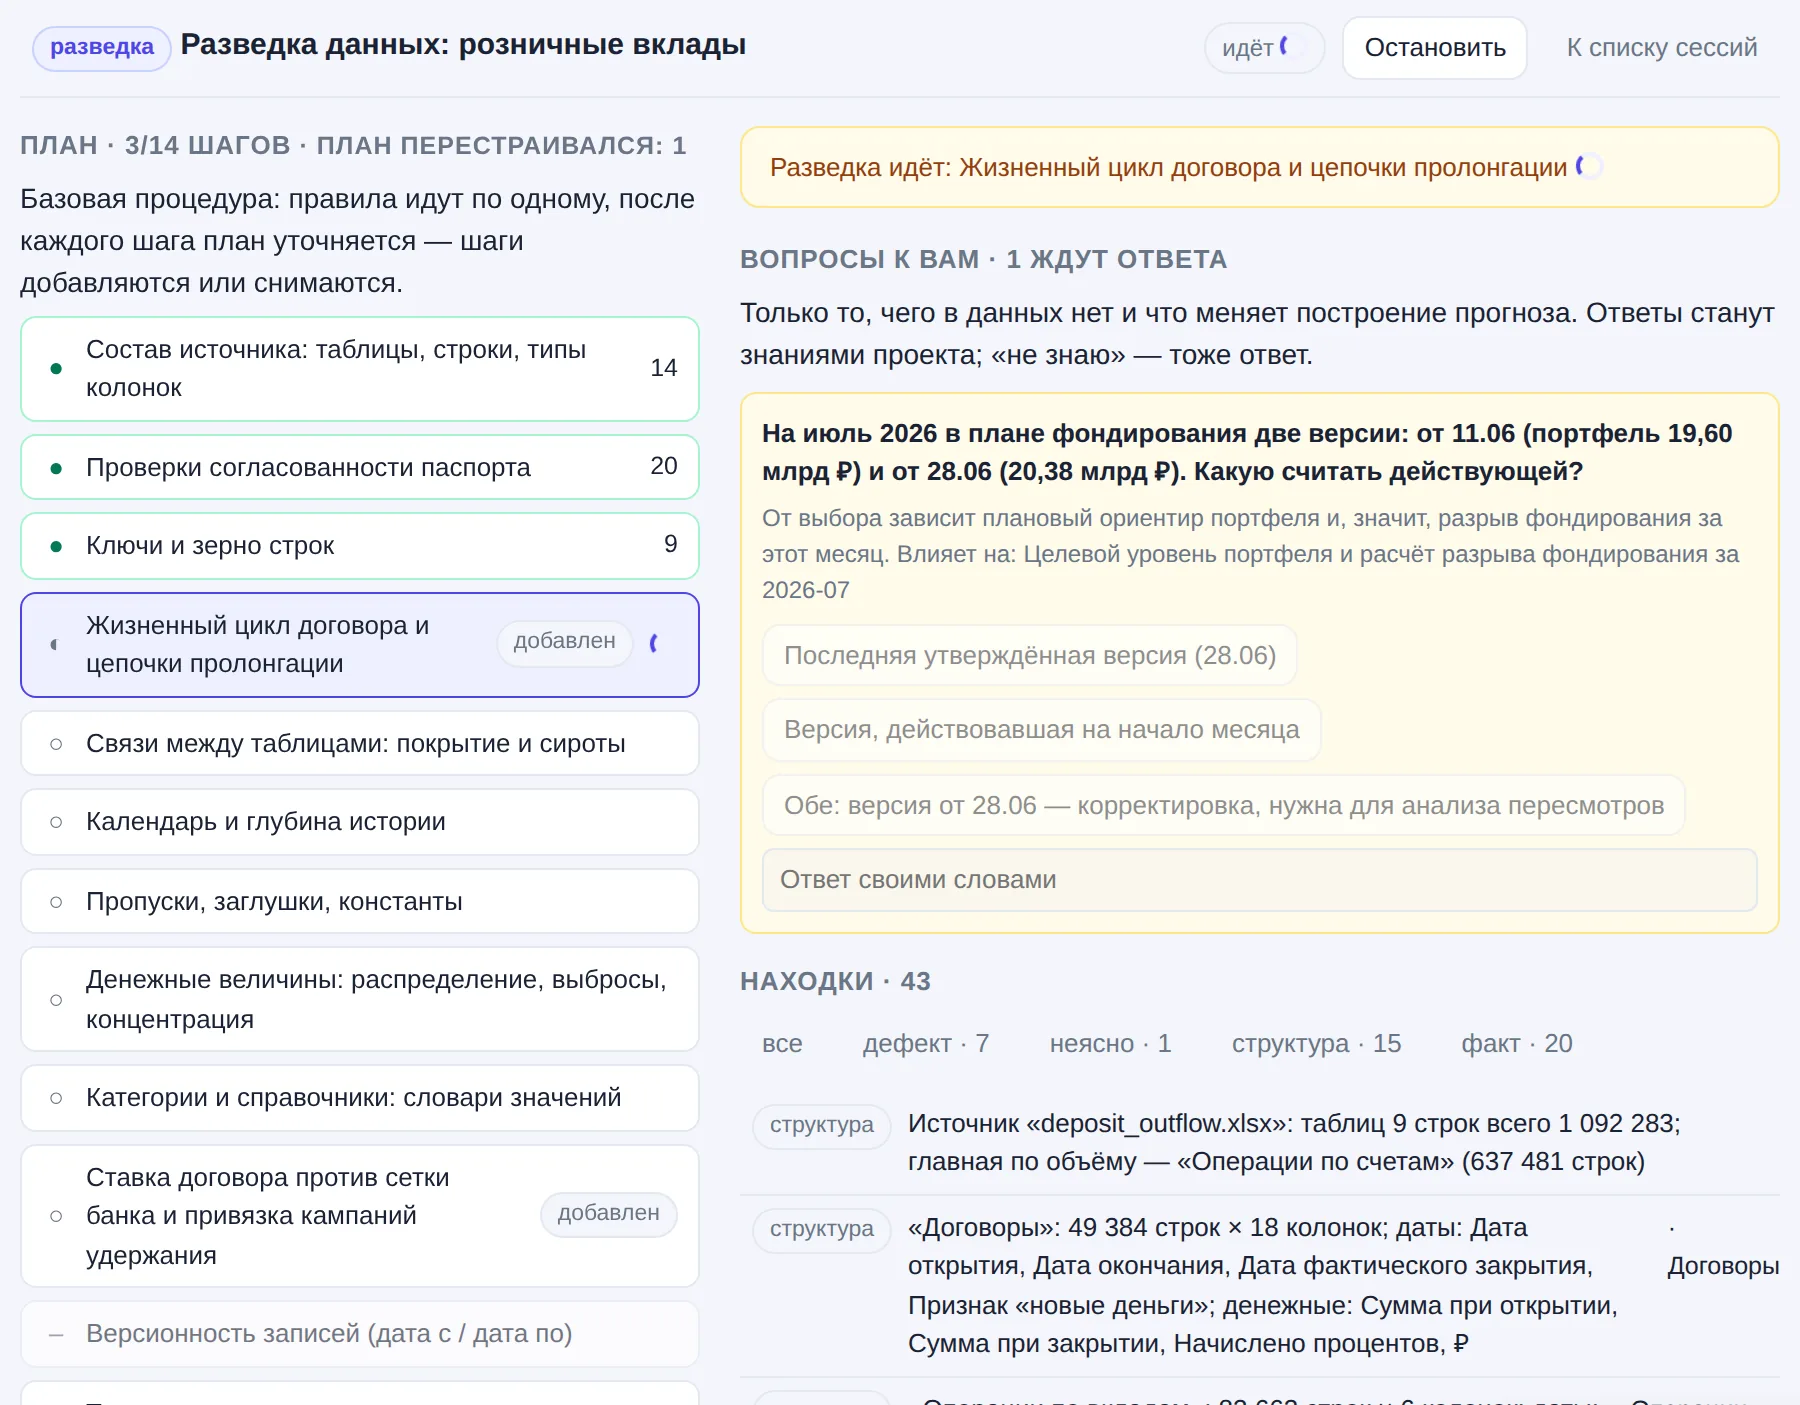
Сначала разбирается, что за данные перед ним
Отдельный режим разведки: состав таблиц, ключи и зерно строк, связи между таблицами, календарь, пропуски и заглушки, сверки между величинами. Находки помечены как структура, факт или дефект, а то, чего в данных нет, агент спрашивает у вас.
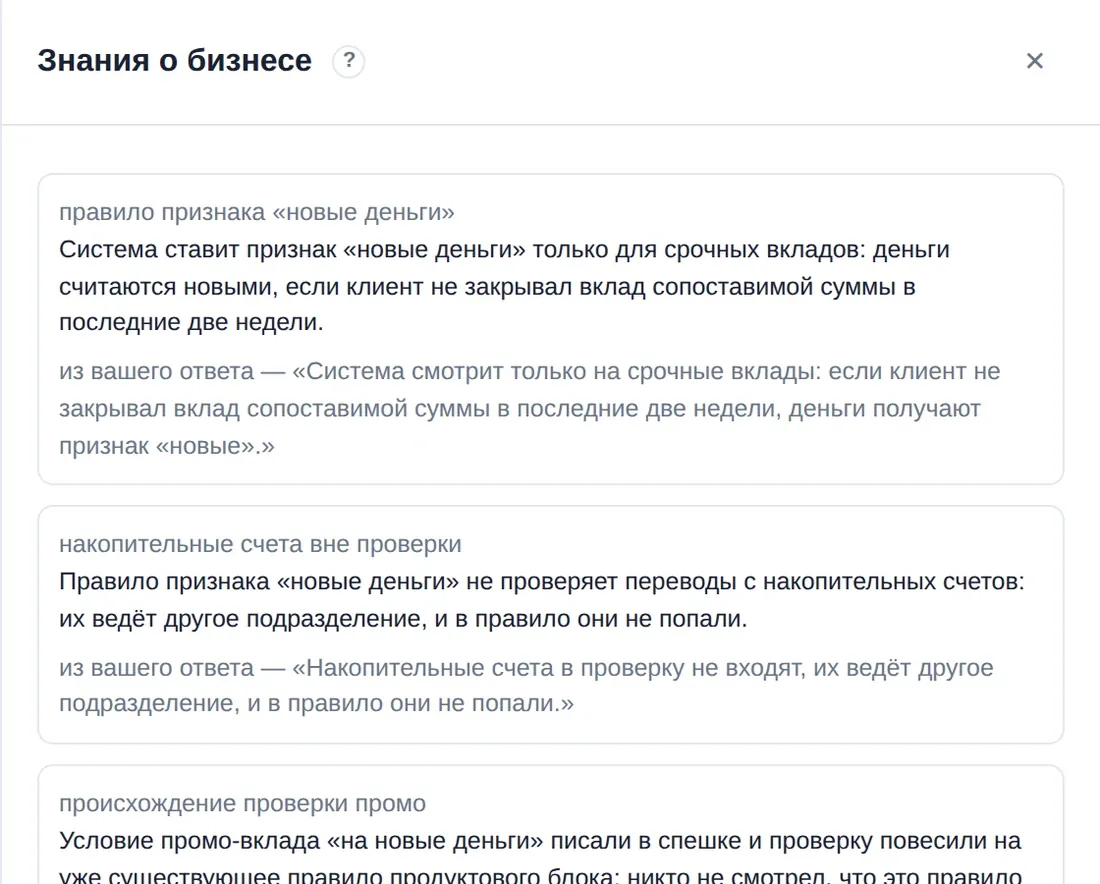
Сохраняет уточнения о данных и бизнесе
Что означает признак «новые деньги», зачем запускали акцию, как определяли ставку — пояснения сохраняются с указанием источника. К ним можно вернуться в следующих исследованиях.
Базовое прогнозирование из коробки
Агент умеет не только объяснить, что было, но и прикинуть, что будет: простые модели временных рядов, тренд и сезонность, регрессия по нескольким факторам. Этого хватает, чтобы оценить, куда идёт показатель, и сравнить факт с ожидаемым: например, отделить эффект акции от сезонного роста.
Прогноз, как и любой расчёт агента, приходит с допущениями, диапазоном неопределённости и кодом, который можно проверить.
Для серьёзного моделирования есть Visiology Горизонт
Сценарное моделирование, прогнозирование и оптимизация с полноценными моделями и управлением допущениями. Дата-агент готовит данные и находки, Горизонт строит на них модель решения.
Методология
Измерение качества во главе угла
У Cortex Дата-агента есть методология измерения качества, а не набор демо. Её ядро это большой набор гиперсинтетических датасетов, курированных отраслевыми экспертами: данные выглядят как живые, с грязью и несогласованностями, но к каждому прилагается ключ с правильными ответами, заложенными дефектами и ловушками. На них одинаково проверяется любой подход, от ChatGPT до нашего агента.
- 1
Отраслевой сценарий
Эксперт описывает бизнес, процессы и то, что в его данных обычно не так: смены методик, дубли, выгрузки из Excel, факты, которые знает только заказчик.
- 2
Данные и ключ
Генератор строит книгу данных по сценарию вместе с ключом: истинные значения, внесённые дефекты и правила их проверки. Эксперт курирует результат.
- 3
Ловушки и ворота
Вопросы, где правдоподобный расчёт неверен, и обязательные условия ответа: заметить дефект, спросить правило, раскрыть скрытый механизм.
- 4
Прогон с повторами
Каждая система отвечает несколько раз. Код переисполняется на копии данных и сверяется с ключом, текст оценивает судья на другой модели.
- 5
Публикация
Состав задач, версии моделей, правила подсчёта и результаты. Любой агент можно оценить по той же методологии и сравнить напрямую.
На этих наборах улучшается обвязка, а не модель. Последовательность шагов, проверки, критик, библиотека практик дорабатываются по результатам прогонов. Сама модель не дообучается, поэтому её можно менять под требования заказчика. Первый набор: розничные вклады банка, пятнадцать сценариев. Дальше наборы по другим отраслям.
Измеримость
Чем этот агент отличается от других и за счёт чего
Дата-агенты и ассистенты внешне делают одно и то же, и выбирать между ними не по чему: качество на реальных задачах никто не измеряет. Мы измеряем на наборах с ключом и сравниваем подходы, а не обещания.
Сколько новых денег принёс промо-вклад?
Вопрос с подвохом. Часть денег на промо-вклад перешла с других вкладов тех же клиентов: валовый приток выглядит убедительно, но ответом не является. Чтобы посчитать правильно, нужно уточнить у заказчика два правила, которых в данных нет: как ставится признак «новые деньги» и зачем запускали акцию. Каждый способ отвечал на вопрос три раза.
Уточнил правила у заказчика
Сколько раз из трёх спросил то, без чего верный ответ недостижим. «0 из 3»: ни разу не спросил и считал по своему предположению.
Нашёл переток с других вкладов
Сколько раз отделил деньги, которые и так лежали в банке, от действительно новых. «0 из 3»: каждый раз выдал валовый приток за новые деньги, то есть уверенно ответил неверно.
Средний балл
Насколько расчёты совпали с ключом по всем проверяемым величинам задачи, от 0 до 1. Полный балл не получил никто.
Модель
Первые два способа это обычный ChatGPT или Claude на Claude Opus 5.5, одной из сильнейших моделей. Агент работает на GLM 5.3 Flash, заметно слабее и дешевле, и всё равно впереди: за счёт дисциплины шагов, а не модели.
| Способ работы | Модель | Средний баллот 0 до 1 | Уточнил правила у заказчикаиз 3 запусков | Нашёл переток с других вкладовиз 3 запусков |
|---|---|---|---|---|
| Файл в чат, один вопросЗагрузить выгрузку в ChatGPT и спросить. Модель отвечает с первой попытки, результат расчёта не видит | Claude Opus 5.5 | 0,55 | 0 из 3 | 0 из 3 |
| Чат с анализом данныхРежим анализа данных в ChatGPT или Claude: модель сама запускает расчёты, смотрит результаты и может переспросить | Claude Opus 5.5 | 0,68 | 0 из 3 | 2 из 3 |
| Cortex Дата-агентТа же модель внутри, но с обвязкой: проверки данных, схема анализа, встречные вопросы, критик расчёта | GLM 5.3 Flash | 0,73 | 3 из 3 | 3 из 3 |
Как считали баллы и что именно сравнивали
Средний балл — оценка расчётов по заранее заданным критериям с учётом их важности для задачи. Верный расчёт получает полный балл, частично верный — часть балла. Значение 0,73 не означает 73% правильных ответов.
Уточнения — в скольких запусках были выяснены оба правила: как присваивается признак «новые деньги» и зачем запустили акцию. В тесте это обязательное условие: без него правильный ответ недостижим.
Переток — в скольких запусках ответ отделил деньги, перешедшие с других вкладов тех же клиентов, от действительно новых. Это ловушка задачи: валовый приток выглядит убедительно, но ответом не является.
Сравниваются три реализации на одном тестовом стенде; код каждой переисполняется на копии данных, текст ответа оценивает судья на другой модели. Это тест подходов к анализу, результаты которого нельзя переносить на готовые продукты ChatGPT или Claude.
Оцените своего агента по той же методологии
Методологию и тестовый набор публикуем открыто: книгу данных, вопросы, ключ и правила подсчёта. Прогоните через них любой дата-агент или ассистент и сравните результат с нашим напрямую, а не по демо. Для включения в сводное сравнение есть закрытый набор и процедура, исключающая подгонку под известные ответы.
В вашем контуре
Работает на ваших серверах и на локальных моделях
Данные не уходят на внешний сервис, а языковая модель подключается любая: облачная по API или развёрнутая у вас. Выигрыш агента даёт дисциплина шагов, а не конкретная модель, поэтому её можно выбирать под требования безопасности и бюджета.
Локальные модели
Любая модель по стандартному API: OpenAI-совместимый, Anthropic или локальная через совместимый шлюз. В тесте выше агент на GLM 5.3 Flash обошёл Claude Opus 5.5 без обвязки.
Данные остаются внутри
Отдельный контейнер в контуре компании. Код агента исполняется в изолированной песочнице без доступа к сети, учётные данные источников хранятся отдельно.
Вместе с Visiology
Единый вход и подключение к модели данных платформы: показатели Visiology доступны агенту наравне с хранилищем и выгрузками. Знания, накопленные в исследованиях, можно перенести в каталог.
Проверьте на своих данных
Возьмите вопрос, на который разные люди в компании называют разные цифры. На тест-драйве проверьте, как агент разбирает ваши данные и насколько удобно аналитику проверить его выводы.